
[AI] 하네스 엔지니어링: AI가 판단할 지점 줄이기
- "하네스 엔지니어링이 뭐지?"라는 질문에서 시작해
harness플러그인까지 만들었다. 먼저 개념과 강제를 둘 자리를 정리했다.- 아직 공부 중인 개념입니다. 조금 틀려도 너른 이해 부탁드립니다!
- 이 글은 개인적인 의견을 다룹니다.
다루는 내용
- 하네스를 "AI가 판단할 지점을 줄이는 방식"으로 정리하고, 지키게 만드는 힘을 어느 층에 둘지 정하면서
목차
1. 규칙을 줬는데, 지킬지는 모델 마음?
2. 하네스는 어디까지?
3. MCP 서버? 지침?
4. 결과적으로?
1. 규칙을 줬는데, 지킬지는 모델 마음?
- 처음 정리는 아티클 없이 Claude와 한 대화 안에서 했다.
- 당시 쓰던 환경은 SKILL.md와 Remote MCP 몇 개였다.
- SKILL.md는 "이럴 때는 이렇게 해라"를 적은 문서다.
- 그 문서를 읽을지, 읽고 따를지는 모델이 정한다.
- 큰 작업 하나를 맡기면 모델이 정하는 것이 꽤 많다.
- 계획부터 세울지
- 어디까지 해야 다 된 것인지
- 테스트를 실제로 돌릴지, 돌렸다고 말만 할지
- 언제 끝났다고 보고할지
- 판단 지점마다 조금씩 어긋날 수 있고, 단계가 길어질수록 그 어긋남이 쌓인다.
- 대화 중에 나온 정리는 아래와 같다.
하네스 단계는 플래닝 → quality gateway → 작업 → quality gateway 같은 것들을 더 강하게 강제하고, AI 판단 포인트를 줄이는 게 목적으로 보인다.
2. 하네스는 어디까지?
- Birgitta Böckeler가 Martin Fowler 사이트에 쓴 Harness engineering for coding agent users(2026-04)는 하네스를 "에이전트에서 모델을 뺀 나머지 전부"로 소개한다.
- 그중 사용자가 자기 프로젝트에 짓는 바깥쪽 하네스를 다룬다.
- 이 글의 분류 두 가지가 도움이 됐다. 하나는 언제 끼어드는지다.
- guide(feedforward): 행동하기 전에 방향을 잡아 주는 것. 지침 문서, 스킬, 규약이 여기에 든다.
- sensor(feedback): 행동한 뒤에 결과를 보고 스스로 고치게 하는 것.
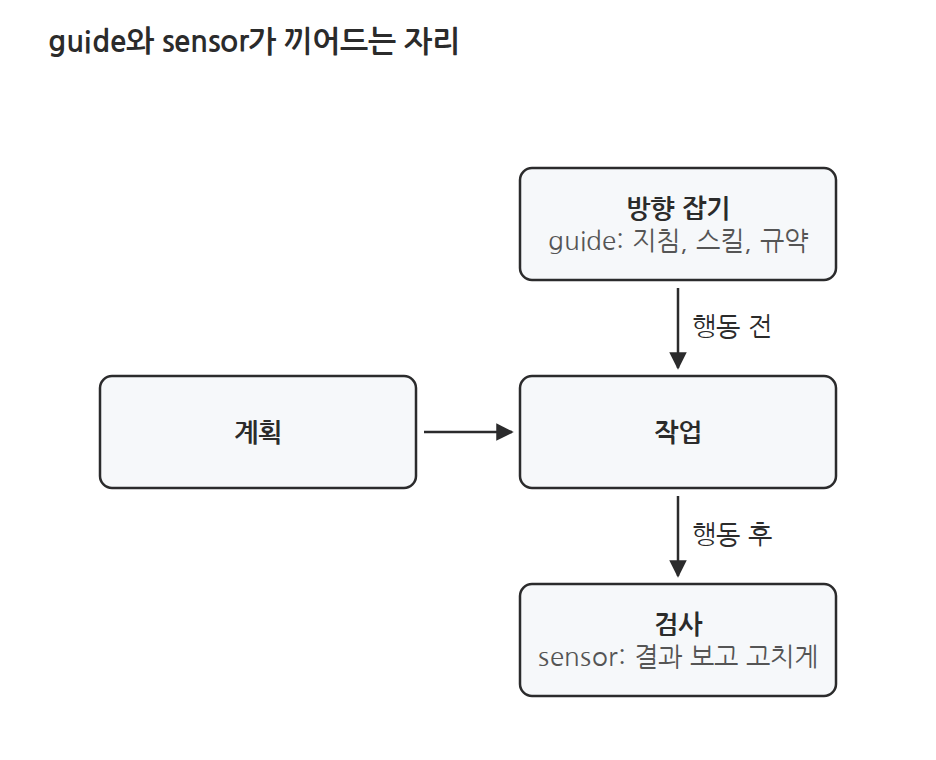 그림 1. guide는 작업 전에 방향을 잡고, sensor는 작업 뒤에 결과를 보고 고치게 한다.
- 다른 하나는 검사의 성격이다.
- computational: 테스트, 린터, 타입 체커처럼 CPU가 돌리는 결정적인 검사
- inferential: AI 코드 리뷰, LLM as judge처럼 의미를 보는 검사. 느리고 비싸고 결과가 매번 같지 않다.
- 내 환경에 대 보면 guide는 이미 있었다. SKILL.md가 그 자리다.
- 비어 있던 것은 sensor, 그리고 guide와 sensor를 정해진 순서로 돌리는 틀이었다.
- 부품 하나하나는 새롭지 않다. 소프트웨어 엔지니어링에서 쓰던 것과 거의 1:1로 맞는다.
| 일반 SE | LLM 도구 |
|---|---|
| 함수, 모듈 | command, SKILL |
| 라이브러리 | MCP |
| 빌드 시스템 | 오케스트레이터 |
| 린트, 테스트, CI | quality gate |
| 사내 규약 | CLAUDE.md, AGENTS.md |
| 프로젝트 템플릿 | 하네스 preset |
- 새로운 점을 하나 꼽으면 inferential 검사, 즉 모델이 검사에 직접 참여한다는 것으로 보인다.
- 이 대화에서 내가 정리한 하네스는 아래와 같다.
- 하네스는 결국 사용자 지침 덩어리다. 그 지침을 지키는 판단까지 AI에 맡긴다.
- 목표는 AI가 고민할 여지를 줄이는 것이다.
3. MCP 서버? 지침?
- 지침이 확률적으로만 지켜진다면, 지키게 만드는 힘은 어디에 둘까? 대화에서 나온 안은 두 가지였다.
- MCP 서버를 신뢰 경계로 둔다 (Claude가 낸 안)
- 단계 전이는 서버의 상태 머신이 맡고, 빠진 값이 있으면 서버가 거부한다.
- 클라이언트가 Code든 Web이든 같은 검사를 거친다.
- 스킬 하나를 MCP 도구와 상태 머신으로 옮기는 설계까지 그렸다.
- 결정적인 강제는 모델 바깥에 두고, 워크플로 본체는 지침으로 간다
- CLAUDE.md, AGENTS.md 같은 지침을 잘게 쪼개고 스킬 사용을 강제한다.
- MCP는 특정 상황에서만 쓴다.
- quality gateway로 부분 루핑을 건다.
- 1을 접은 이유는 두 가지다.
- 토큰: 도구 호출, 거부, 재호출이 이어질 때마다 왕복이 늘어 사용량이 급증한다.
- 모델 협조: MCP는 판단을 맡기는 도구보다 실행하는 최종단에 가깝다. 모델이 그 도구를 부르기로 해야 검사가 돈다.
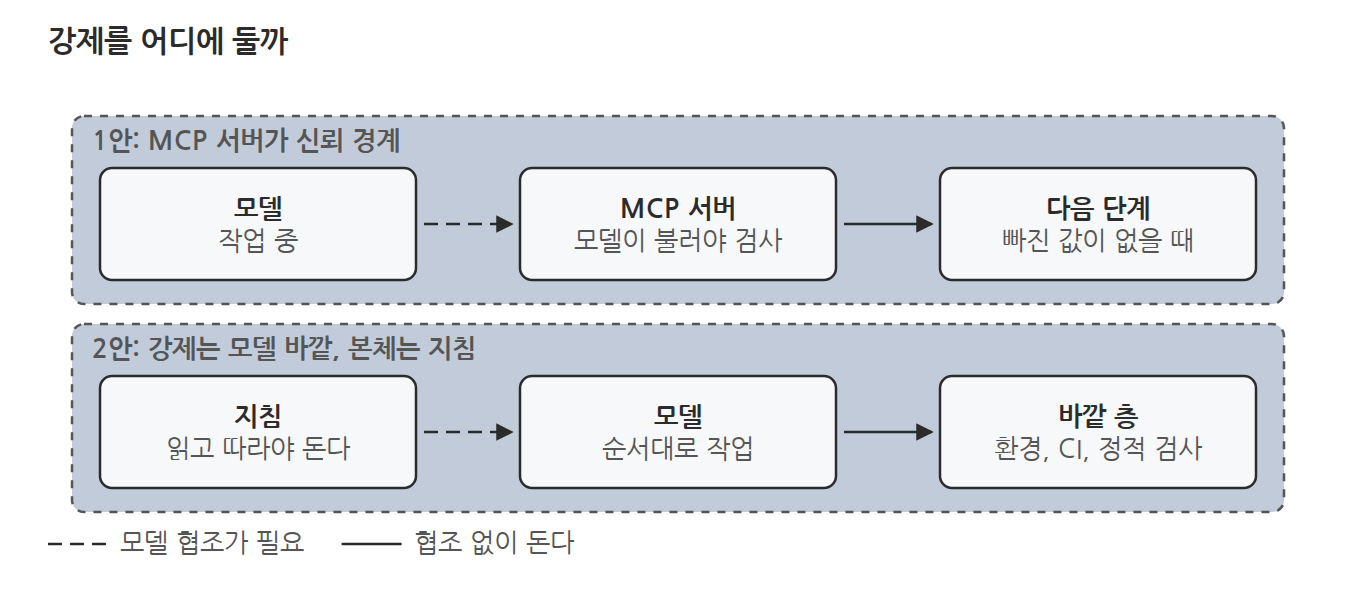 그림 2. 1안은 모델이 도구를 불러야 검사가 돌고, 2안은 바깥 층이 모델 협조 없이 막는다.
- 강제력을 층으로 나누면 아래와 같다.
| 층 | 예 | 모델 협조가 필요한가? |
|---|---|---|
| 환경 | sandbox, 권한 분리, 네트워크 격리 | 필요 없다 |
| CI | 머지·배포 차단 | 필요 없다 |
| 정적 검사 | 린트, 타입, 테스트 | 필요 없다 |
| 다른 모델 | LLM as judge | 일부 |
| MCP 도구 | 파라미터 검증, 상태 머신 | 필요하다 |
| 지침 | SKILL.md, CLAUDE.md | 필요하다 |
결과적으로 2로 결정했다. 모델 협조 없이 막는 힘은 위 세 층에 있다. 나머지는 순서를 고정해서 지침이 잘 지켜지게 하면 된다고 봤다.
- 예외도 하나 남겼다. MCP로 다른 언어 모델들을 불러 한 모델의 인지 편향을 벗어나는 구조라면 MCP가 의미 있을 수 있다.
- 이 예외는 다른 모델에게 검증을 맡기는 이유에서 이어진다.
- 이 정리를 옮긴 플러그인은 harness 플러그인: 계획과 검사를 고정하는 6단계에서 다룬다.
4. 결과적으로?
- 하네스는 계획 → 검사 → 작업 → 검사라는 순서를 모델 판단에서 빼서 고정하는 방식이다. 스킬, 훅, MCP는 그 순서를 채우는 부품이다.
- 강제는 모델 협조가 필요 없는 바깥 층에 두고, MCP는 특정 상황에서만 쓴다.
- 하네스는 도구 하나보다 일하는 방식, 패러다임으로 보는 게 맞다고 정리했다.